Introducción a la computación en biología
La pregunta es biológica, pero la respuesta exige computación
La biología sigue empezando con preguntas biológicas:
- ¿Qué especies están sufriendo cambios de rango de distribución debido al cambio global?
- ¿Qué genes se expresan en una condición experimental?
- ¿Qué variantes distinguen dos poblaciones?
- ¿Cómo cambia una comunidad microbiana entre muestras?
- ¿Qué regiones del genoma están metiladas?
Pero, en muchos proyectos actuales, responder estas preguntas exige trabajar con una cantidad de datos que requieren del uso de herramientas informáticas.
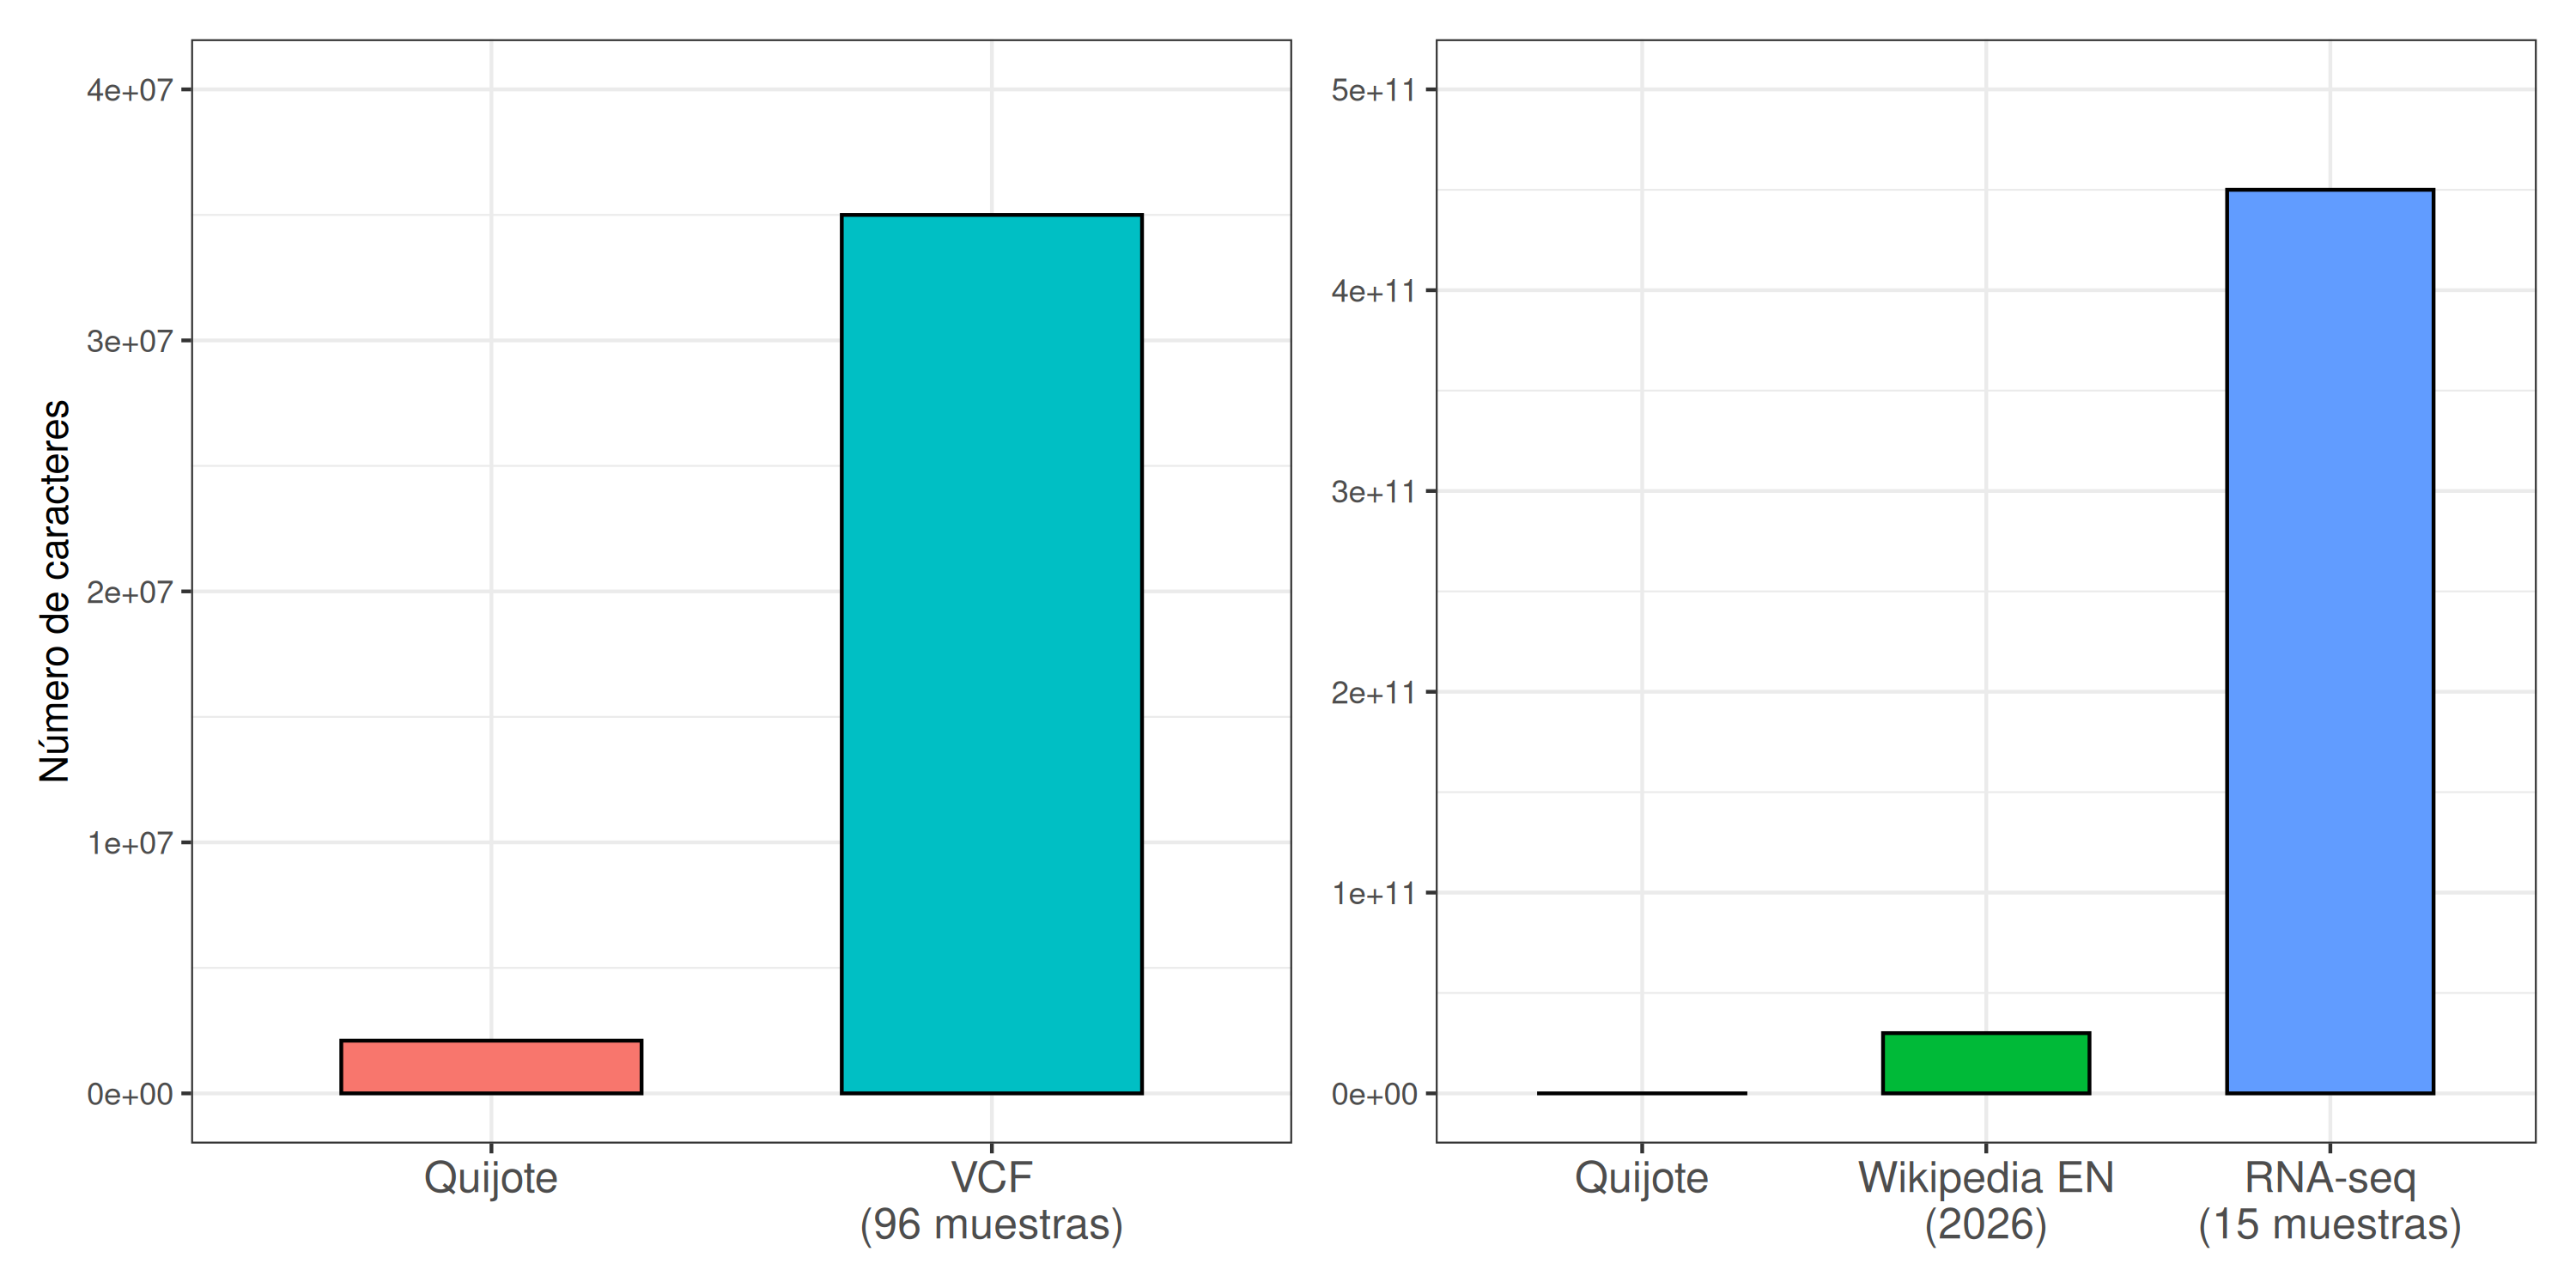
Necesitamos maneras automatizadas para:
- Leer miles o millones de registros.
- Seleccionar y filtrar datos.
- Contar, resumir y calcular estadísticas.
- Comparar muestras, poblaciones o tratamientos.
- Registrar exactamente qué pasos se han aplicado.
| Tarea | A mano | Con comandos o un script |
|---|---|---|
| Contar observaciones por especie | Posible con pocas filas | Rápido con miles o millones de filas |
| Seleccionar lecturas largas | Imposible a escala real | Un criterio aplicado a todas las lecturas |
| Comparar muestras | Difícil de repetir exactamente | Repetible y documentable |
| Corregir un criterio de filtrado | Hay que repetir pasos manuales | Se cambia una instrucción y se vuelve a ejecutar |
| Explicar qué se hizo | Depende de notas y memoria | El código conserva el procedimiento |
La idea central del curso es la siguiente:
Si puedes expresar una tarea como una secuencia clara de instrucciones, puedes pedir al ordenador que la ejecute sobre todos los datos.
Durante el curso aprenderás dos formas complementarias de hacerlo:
- Línea de comandos: instrucciones breves para inspeccionar, buscar, filtrar, combinar y transformar archivos.
- Python: programas más flexibles para automatizar análisis y crear resultados a partir de datos.
Sistemas abiertos: por qué importan
En este curso utilizaremos herramientas abiertas o basadas en estándares abiertos: Linux, bash, Python y formatos de texto habituales en biología.
Un sistema abierto no significa necesariamente que todo sea gratuito o que cualquier dato deba ser público. Significa, sobre todo, que las reglas de funcionamiento y los formatos son accesibles, documentados y utilizables por distintas personas y programas.
Esto tiene ventajas prácticas importantes.
- Transparencia. Puedes inspeccionar qué contiene un archivo y qué hacen las instrucciones que ejecutas.
- Reproducibilidad. Otra persona puede repetir el mismo análisis con los mismos datos y las mismas instrucciones.
- Interoperabilidad. Un archivo FASTA, VCF o GFF3 puede ser leído por muchas herramientas diferentes, no solo por el programa que lo creó.
- Durabilidad. Un archivo de texto documentado suele seguir siendo interpretable años después, incluso aunque cambie el programa original.
- Automatización. Los formatos bien definidos permiten conectar pasos en un análisis: la salida de una herramienta puede ser la entrada de otra.
- Comunidad. Las herramientas abiertas permiten detectar errores, compartir mejoras, crear tutoriales y aprovechar trabajo previo.
Archivos de texto
Una característica de los sistemas Unix es que todo es un archivo de texto. Un archivo de texto es aquel que contiene únicamente texto plano, formado por caracteres legibles como letras, números, tabuladores, signos de puntuación y saltos de línea, sin estilos tipográficos ni imágenes. Los programas, los datos y la configuración se almacenan en archivos que pueden ser leídos y modificados con un editor de texto.
Esto es una diferencia importante respecto a otros sistemas, donde los programas y los datos se guardan en archivos binarios que solo pueden ser interpretados por el programa que los creó.
El tipo de datos con los que nos encontraremos en Biología Computacional y con los que podremos trabajar será texto plano. Estos son fáciles de inspeccionar, filtrar y transformar mediante instrucciones de línea de comandos o scripts.
Además, los formatos de texto bien definidos permiten que distintas herramientas puedan leer y escribir los mismos datos. Pero no basta con que un archivo se vea ordenado: para que sea fácil de analizar debe tener una estructura clara y consistente.
Examina este ejemplo de archivo de datos de campo:
x,fecha,temperatura,especie,número individuos
1,12/5/24,22.5,Quercus robur,3
2,2024-05-12,23 C,Q. robur,muchos
03,12 mayo,NA,Quercus_robur,-
4,12 mayo,Qercus_robur,5
- ¿Es un documento de texto plano?
- ¿Hay columnas?
- ¿Qué problemas de consistencia y claridad tiene?
Características esenciales
Un buen archivo de texto para análisis suele cumplir estas reglas:
- Una observación o registro por línea, cuando el formato lo permite.
- Una estructura repetida y predecible. Todas las filas de una tabla tienen las mismas columnas; todos los registros FASTQ tienen cuatro líneas.
- Separadores claros y constantes. Comas, tabuladores o un formato formalmente definido.
- Cabeceras informativas. Los nombres de las columnas explican qué representa cada valor.
- Identificadores únicos y estables. Por ejemplo,
sample_id,read_idogene_id. - Datos atómicos. Una celda o campo debe contener una sola clase de información.
- Valores ausentes definidos. Por ejemplo, usar
NAo un campo vacío de manera consistente, no una mezcla de-,?,sin datoy celdas vacías. - Unidades y convenciones explícitas. Por ejemplo,
temperature_Cen lugar detemperatura, olatitude_decimal_degreesen lugar delatitud. - Codificación de caracteres conocida. Preferiblemente UTF-8.
- Sin formato visual oculto. Un archivo de texto no depende de negritas, colores, celdas combinadas o fórmulas invisibles.
- Metadatos y documentación. Debe ser posible saber quién generó el archivo, qué representa cada campo y con qué procedimiento se obtuvieron los datos.
Formatos estándar en biología
En vez de inventar un formato propio para cada proyecto, la biología usa formatos estandarizados. Cada formato describe una clase concreta de datos y tiene reglas que las herramientas pueden reconocer.
| Formato | Contenido habitual | Pista visual | Ejemplo de uso |
|---|---|---|---|
| CSV o TSV | Tablas | Cabecera y columnas separadas por comas o tabuladores | Datos de campo, metadatos de muestras, resultados |
| FASTA | Secuencias de ADN, ARN o proteína | Cabecera que empieza por > |
Secuencia de un gen o genoma de referencia |
| FASTQ | Lecturas crudas y sus calidades | Registros de cuatro líneas; primera línea empieza por @ |
Salida de un secuenciador |
| GFF3 | Anotaciones sobre una secuencia | Nueve columnas separadas por tabuladores | Genes, exones, CDS y otras regiones |
| VCF | Variantes genéticas | Cabeceras que empiezan por ## y #CHROM |
SNPs e indels entre muestras |
| Newick | Árboles filogenéticos | Paréntesis, comas y punto y coma final | Filogenias y dendrogramas |
CSV y TSV: tablas de datos
CSV significa comma-separated values; TSV significa tab-separated values. Ambos son formatos de tabla. Cada fila representa una observación y cada columna una variable.
sample_id,site,sampling_date,species,individual_count
S001,Albufera,2024-05-12,Ardea_cinerea,3
S002,Albufera,2024-05-12,Egretta_garzetta,7
S003,Pego-Oliva,2024-05-14,Ardea_cinerea,1
FASTA: secuencias
Un archivo FASTA contiene secuencias de ADN, ARN o proteína. Cada secuencia comienza con una cabecera que empieza por >.
>gene_001|Arabidopsis_thaliana|rbcL
ATGTCACCACAAACAGAGACTATCGACTGCTGCTGCTGCTGCTGCTGCTG
GCTACGGTTCACATGA
>gene_002|Pinus_sylvestris|rbcL
ATGACCATGATTACGCCAAGCTTGGCACTGCTGCTGCTGATGCGTSi quisiera contar cuántas secuencias hay en un archivo FASTA, ¿qué debería hacer?
FASTQ: lecturas y calidad
FASTQ almacena lecturas producidas por un secuenciador. Cada lectura ocupa exactamente cuatro líneas:
@read_0001
GATTACAGATTACAGATTACA
+
IIIIIIIIIIIIIIIIIIIII
Las cuatro líneas son:
- Identificador de la lectura.
- Secuencia de nucleótidos.
- Separador, normalmente
+. - Calidad de cada base, codificada mediante caracteres.
GFF3: anotaciones de un genoma
GFF3 se usa para indicar dónde están las regiones anotadas de una secuencia: genes, exones, intrones, CDS, repeticiones, etc. Cada registro tiene nueve columnas separadas por tabuladores.
##gff-version 3
chr1    annotation  gene    1001    5000    .   +   .   ID=gene001;Name=RBCS1
chr1    annotation  mRNA    1001    5000    .   +   .   ID=transcript001;Parent=gene001
chr1    annotation  exon    1001    1200    .   +   .   Parent=transcript001
chr1 annotation mRNA 1015 5200 . + . ID=transcript002;Parent=gene001¿Cómo podría tener una idea aproximada del número medio de transcritos por gen?
VCF: variantes genéticas
VCF significa Variant Call Format. Se usa para representar variantes respecto a un genoma de referencia.
##fileformat=VCFv4.2
##INFO=<ID=GT,Number=1,Type=String,Description="Genotype">
##INFO=<ID=DP,Number=1,Type=Integer,Description="Total Depth">
##INFO=<ID=RO,Number=1,Type=Integer,Description="Reference allele observation count">
##INFO=<ID=AO,Number=1,Type=Integer,Description="Alternate allele observation count">
#CHROM  POS ID  REF ALT QUAL    FILTER  INFO SAMPLE1
chr1    14370   rs123   G   A   29  PASS    GT:RO:AO:DP 0/1:8:1:9
chr2    6980    rs345   T   C   52  PASS    GT:RO:AO:DP 1/1:0:12:12
Buenas prácticas para el curso
A continuación te dejo algunas recomendaciones para evitar problemas comunes.
Evitar nombres problemáticos
El uso de nombres descriptivos para archivos, carpetas y variables es fundamental para que tu trabajo sea comprensible y reproducible. Un nombre claro permite a otra persona (o a ti mismo dentro de seis meses) entender qué contiene un archivo o qué representa una variable sin tener que abrirlo o inspeccionarlo.
La regla principal es sencilla:
Usa nombres simples para el ordenador y descriptivos para las personas.
| Poco informativo | Mejor alternativa | Qué comunica |
|---|---|---|
datos.csv |
2026-05-12_albufera_aves.tsv |
Fecha, lugar, organismo y formato |
final.fasta |
pinus_sylvestris_rbcl_alineado.fasta |
Especie, marcador y procesamiento |
archivo1.fastq |
muestra_s003_r1.fastq.gz |
Identificador de muestra y lectura 1 |
resultado.txt |
conteo_especies_por_parcela.tsv |
Contenido del resultado |
final_final_v2.csv |
muestras_filtradas_calidad30.csv |
Criterio aplicado al archivo |
script.py |
contar_lecturas_fastq.py |
Qué hace el programa |
No hace falta que los nombres sean interminables. Deben contener la información mínima que permita distinguir archivos y comprender su propósito.
Si usas nombres como datos.csv, final.csv, final_final.csv, cosas_buenas.csv es posible que acabes en el infierno
Nombres de archivos y carpetas
La recomendación general es:
- Letras minúsculas:
muestras.csv, noMuestras.CSV. - Números cuando ayuden a ordenar o identificar:
muestra_001.fastq. - Si usas números que tengan el mismo número de dígitos, rellena con ceros a la izquierda:
muestra_001.fastq,muestra_002.fastq, …,muestra_010.fastq. - Guion bajo (
_) para separar palabras: mejordatos_muestreo_2026.csvquedatos de muestreo 2026.csv. - Una extensión coherente con el formato:
.csv,.tsv,.fasta,.fastq,.vcf,.gff3o.txt. - Fechas en formato
AAAA-MM-DDoAAAAMMDD, para que se ordenen correctamente:2026-09-04_muestras_albufera.tsv. - Usar solo caracteres ASCII simples. Usa solo letras minúsculas sin acentos (
a-z), números (0-9). - Evita símbolos con significado especial en la terminal:
*,?,!,$,&,;,|,(,),[,],{o comillas.
En Linux las extensiones no son obligatorias, pero ayudan a identificar el formato y a abrir el archivo con el programa adecuado.
Nombres de variables
Una variable guarda un valor al que queremos referirnos en un programa. Igual que un archivo, su nombre debe indicar qué representa.
x = 22.5
n = 150
a = "Albufera"
Estas variables son válidas, pero no explican por sí mismas qué contienen. Una versión más clara sería:
temperatura_c = 22.5
numero_lecturas = 150
sitio_muestreo = "Albufera"
La diferencia no es cosmética: con nombres malos, entender qué hace el código exige reconstruir mentalmente qué representa cada letra. Compara estas dos funciones, que hacen exactamente lo mismo:
def f(x, y, z):
    a = x / y
    return a >= z
def supera_umbral_calidad(lecturas_pasan_filtro, lecturas_totales, umbral_minimo):
proporcion_pasa_filtro = lecturas_pasan_filtro / lecturas_totales
return proporcion_pasa_filtro >= umbral_minimoPEP 8, la guía de estilo de Python, recomienda la convención snake_case para variables y funciones. [@pep8]
RTFM y RTFE
En informática hay una máxima que se repite constantemente:
RTFM — Read The Fucking Manual
Generalmente todos los programas tienen documentación que responde a:
- ¿Qué hace exactamente este programa?
- ¿Qué formato de entrada espera?
- ¿Qué columnas o campos son obligatorios?
- ¿Qué significan las opciones disponibles?
- ¿Qué archivo genera como salida?
- ¿Qué versión del programa se ha usado?
- ¿Qué limitaciones o supuestos tiene el método?
En la terminal, muchos programas ofrecen una ayuda rápida:
comando --helpo bien:
man comandoNo necesitas entender todo el manual de una vez. Busca primero:
- Qué problema resuelve la herramienta.
- Qué archivo espera como entrada.
- Qué salida produce.
- Un ejemplo mínimo de uso.
- El significado del error que aparece.
La segunda frase que debes recordar es:
RTFE — Read The Fucking Error
Traducido de forma útil:
Lee el mensaje de error completo antes de probar soluciones al azar.
Un error no es una prueba de que “no sirves para programar”. Es información sobre la diferencia entre lo que el programa esperaba y lo que recibió.
Por ejemplo:
FileNotFoundError: [Errno 2] No such file or directory: 'muestras.csv'Esto no significa “Python está roto”. Significa que Python no encuentra un archivo llamado muestras.csv en la ubicación desde la que se ejecutó el programa.
Comprueba, en este orden:
- ¿Existe realmente el archivo?
- ¿Está escrito exactamente igual, incluidas mayúsculas y minúsculas?
- ¿Estás trabajando en el directorio correcto?
- ¿Tiene una extensión inesperada, por ejemplo
muestras.csv.txt? - ¿La ruta indicada es correcta?